Прогнозирование и выбор модели
[25/84%]Объясните, как можно было бы вычислить гребневую оценку , используя программу метода наименьших квадратов.
Рассмотрим регрессию с двумя ортогональными центрированными и масштабированными объясняющими переменными и . Используя методы примера 12.2 из раздела 12.4.1, вычислите вероятность правильного определения истинной модели с помощью пошагового отбора, когда коэффициенты регрессии для и оба равны нулю. Используйте значение и предположите, что дисперсия ошибки равна 1.
Рассмотрим регрессию с объясняющими переменными. Пусть — -статистика для проверки того, что некоторое заданное подмножество из переменных можно исключить из модели, где . Покажите, что значение для этой сокращённой модели с исключёнными переменными равно .
Проверьте (12.85).
Покажите, что квадрат полного смещения равен первому слагаемому в (12.8).
Рассмотрим регрессионную модель
где и . Предположим, что мы хотим предсказать отклик , соответствующий вектору , используя предиктор вида
где — оценка наименьших квадратов, полученная подгонкой модели
Предполагая, что модель (12.13) верна, покажите, что математическое ожидание ошибки модели предиктора задаётся выражением
где .
При каких условиях будет лучшим предиктором, чем предиктор, основанный как на , так и на ?
Докажите, что
Проведите небольшую симуляцию, чтобы оценить, насколько сильно занижает ошибку предсказания в примере 12.1.
Докажите, что . Можете предполагать, что и для всех x. Указание: покажите, что при , и положите .
Получите (12.35), используя рассуждения об условной вероятности.
Покажите, что первый шаг прямого отбора эквивалентен выбору переменной, наиболее сильно коррелированной с откликом.
Покажите, что переменная, увеличивающая разность на наибольшую величину, — это та переменная, которая имеет наибольшую частную корреляцию с откликом при заданных уже включённых в модель переменных.
В примере 12.2 проверьте алгоритм 12.2 и определите области, соответствующие подмножествам, выбранным (а) обратным исключением, (б) пошаговой регрессией.
Проверьте, что маргинальное распределение в байесовской постановке раздела 12.5.1 есть .
Покажите, что когда , величина во второй версии гарроты задаётся формулой
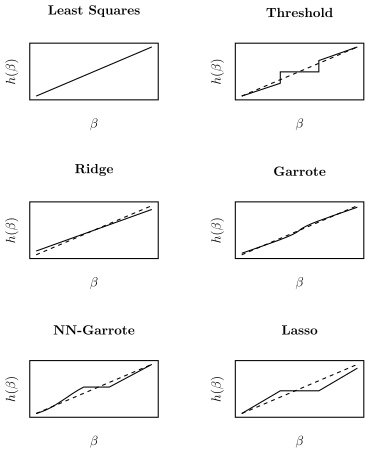 Рис. 12.4 Функции, задающие сжимающие оценки в ортонормированном случае. Сжимающая оценка \tilde{\beta }{j} равна h\left(\widehat{\beta }{j}\right).
Проверьте (12.65). Указание: используйте формулу обращения блочной матрицы A.9.1 и раскройте квадратичную форму.
Найдите вид апостериорной прогностической плотности для линейной регрессии. Предположите, что объясняющая переменная центрирована и что априорное среднее равно нулю. Также предположите, что вы предсказываете единственное значение (т.е. считайте, что ).
Рассмотрим модель регрессии
где и . Пусть . Предположим, что мы оцениваем параметр с помощью оценки
где — некоторая положительная константа. Как СКО оценки как оценки соотносится со СКО обычной МНК-оценки?
Предположим, что вы используете пошаговый отбор для выбора либо нулевой модели , либо модели простой линейной регрессии из упражнения 1 выше. Объясните, как бы вы вычислили условную плотность (12.74) в этой ситуации.
Для любой пары случайных векторов и покажите, что разность является положительно полуопределённой. Указание: покажите, что эта разность равна .
Напишите небольшую компьютерную программу для вычисления остаточной суммы квадратов для всех возможных регрессий с использованием алгоритма Гарсайда. Задачи какого размера можно разумно обработать?
Реализуйте алгоритм Моргана и Татара. Какие улучшения вы замечаете по сравнению с алгоритмом Гарсайда?
Покажите, что функция , которая минимизирует ожидаемую МО (12.80), есть условное математическое ожидание , задаваемое формулой (12.81).
Постройте ту же диаграмму для примера 12.6, что и приведённые в тексте в примерах 12.4 и 12.5.
Покажите, что в гребневой регрессии, когда , малый бутстрап и обобщённая перекрёстная проверка (GCV) дают одну и ту же оценку для гребневого параметра.